从 MHA 到 MLA:DeepSeek 多头潜在注意力的完整计算流程
本文把 DeepSeek 的 MLA(Multi-head Latent Attention,多头潜在注意力) 从头到尾走一遍:它为什么存在、核心想法是什么、RoPE 为什么要"解耦"、"吸收技巧"怎么让推理省掉上投影,以及一层 MLA 的前向计算在 prefill 和 decode 时分别长什么样。
文中数字使用 DeepSeek-V3 的公开配置;标注"推算"的数字是我基于该配置自己算的,不是论文给出的结论。
最后一节会交代 MLA 没解决的问题,以及它如何引出 DeepSeek-V3.2 的 DSA 和 V4 的 CSA / HCA。
1. 背景:KV Cache 为什么是瓶颈
大模型自回归生成时,每生成一个新 token,都要拿它的 query 去和所有历史 token 的 K、V 做注意力。历史 token 的 K、V 不会变,所以算一次存起来,这就是 KV Cache。
标准多头注意力(MHA)里,每个 token、每层要缓存 K 和 V:
2nhdh=2×128×128=32768 个数
其中 nh 是头数,dh 是每头维度。换算到整个模型(BF16,每个数 2 字节,61 层):
32768×2 B×61≈4 MB / token
以上为推算,假设 BF16 缓存、V3 的 61 层配置。
KV Cache 的大小直接决定了能支持多长的上下文、多大的 batch。所以降低每个 token 的缓存量,是推理系统里最核心的优化方向之一。
本文使用的配置(DeepSeek-V3)
| 符号 |
含义 |
数值 |
| d |
隐藏维度 |
7168 |
| nh |
注意力头数 |
128 |
| dh |
每头内容维度 |
128 |
| dc |
KV 压缩维度(kv_lora_rank) |
512 |
| dc′ |
Q 压缩维度(q_lora_rank) |
1536 |
| dR |
RoPE 专用维度(qk_rope_head_dim) |
64 |
| L |
层数 |
61 |
2. 前人的办法:MQA 与 GQA
| 方案 |
做法 |
代价 |
| MHA |
每个头有自己的 K、V |
缓存最大 |
| MQA |
所有头共享同一组 K、V,缓存缩小到 1/nh |
各头"看"的内容完全一样,表达能力下降 |
| GQA |
每几个头共享一组 K、V |
在缓存和质量之间折中 |
它们的思路都是砍头数,用质量换缓存。MLA 换了一个思路:不砍信息,而是压缩信息。
3. MLA 的核心想法:低秩联合压缩
标准 MHA 里,K 和 V 都是从同一个隐状态 ht 经过两个大矩阵算出来的,二者之间有大量冗余。那就先把 ht 压成一个低维潜向量,缓存这个潜向量;需要 K、V 时再从它升维还原。
设第 t 个 token 的隐状态为 ht∈Rd。
KV 一路:下投影得到潜向量,再用两个上投影矩阵还原:
ctKV=WDKVht∈Rdc
ktC=WUKctKV,vtC=WUVctKV
K 和 V 共用同一个 ctKV,所以叫联合压缩。缓存里存的是 ctKV(512 个数),而不是完整的 K、V(32768 个数)。
Q 一路:同样做低秩分解,但这只是为了省参数和训练时的激活内存,不影响推理缓存:
ctQ=WDQht,qtC=WUQctQ
下图是 KV 一路的数据流:
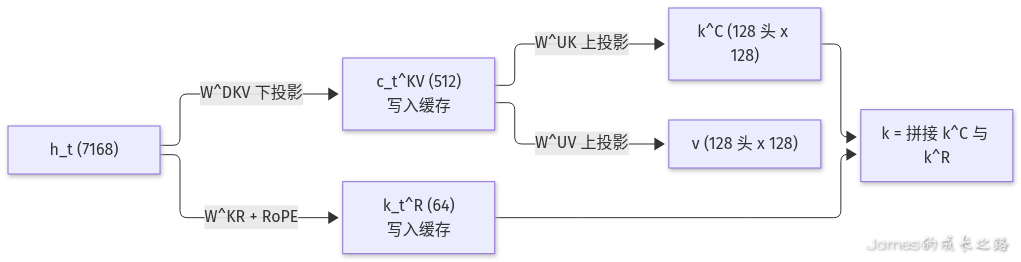
图里多出来的那条 ktR 分支,是下一节要讲的"解耦 RoPE"。
4. RoPE 带来的麻烦与"解耦"
RoPE 给 query 和 key 做与位置相关的旋转。注意力分数里会夹着一个只依赖相对位置的旋转矩阵 Rt−j:
scoret,j=qt⊤Rt−jkj
把 qt=WUQctQ 和 kj=WUKcjKV 代入:
scoret,j=(ctQ)⊤依赖 t−j,无法预先合并(WUQ)⊤Rt−jWUKcjKV
下一节的"吸收技巧"需要把 WUQ 和 WUK 提前乘成一个固定矩阵。但中间夹着随位置变化的 Rt−j,这一步就做不了。这就是为什么不能直接对缓存里的 cKV 做 RoPE。
MLA 的做法是解耦 RoPE:位置信息交给额外的 dR=64 维单独承载。
ktR=RoPE(WKRht)(所有头共享)
qtR=RoPE(WQRctQ)(每头一份)
第 i 个头的 query 和 key,都是"内容部分 + 位置部分"的拼接:
qt,i=[qt,iC; qt,iR],kj,i=[kj,iC; kjR]
两者的维度都是 128+64=192。
缓存里实际存的是 cjKV 和 kjR:
dc+dR=512+64=576 个数 / token / 层
与 MHA 相比缩小约 32768/576≈57 倍(推算)。
5. 吸收技巧:让推理不再还原 K、V
朴素做法的问题是:每步 decode 都要把所有历史 token 的 cj 还原成 K、V,代价是 n 次大矩阵乘,太慢。
MLA 利用矩阵乘法的结合律,把上投影挪到 query 一侧。
5.1 分数一侧(内容部分)
(qt,iC)⊤kj,iC=(qt,iC)⊤WiUKcjKV=((WiUK)⊤qt,iC)⊤cjKV
令
q~t,i=(WiUK)⊤qt,iC∈Rdc
这样分数直接和缓存的 cjKV 做点积,不用还原 K。
5.2 输出一侧
ot,i=j∑at,jWiUVcjKV=WiUV(j∑at,jcjKV)
先在 512 维潜空间里加权求和,最后再升维。WiUV 还可以并进输出投影 WO。
5.3 吸收之后的形态
每个 query 头的分数变成:
scoret,j(i)=dh+dRq~t,i⊤cjKV+(qt,iR)⊤kjR
此时:
- 键是 [cjKV;kjR]∈R576
- 值是 cjKV∈R512
- 这对键值被全部 128 个头共享
所以推理形态的 MLA,等价于一个单头的 MQA。后面 DeepSeek-V3.2 论文里说的 “MQA mode of MLA”,指的就是这个形态。
注意:吸收只是改变了计算顺序,数学上和展开形式是同一个注意力,所以缩放因子依然是 192。这里忽略 YaRN 带来的缩放修正。
6. 一层 MLA 的完整前向流程
MLA 在训练 / prefill 和 decode 时的计算形式不同,下面分开写。
输入是当前层的隐状态 ht∈R7168。
6.1 公共部分:生成 Q,并写缓存
Query 路径
| 步骤 |
运算 |
输出形状 |
| 1 |
下投影 + RMSNorm:ctQ=RMSNorm(WDQht) |
[1536] |
| 2 |
上投影 WUQctQ,再 reshape |
[128,192] |
| 3 |
切成内容段和位置段:qt,iC∈R128,qt,iR∈R64 |
[128,128] 与 [128,64] |
| 4 |
只对位置段做 RoPE |
[128,64] |
KV 路径(写入缓存的就是这一路)
| 步骤 |
运算 |
输出形状 |
| 5 |
一次投影得到两部分:[ctKV; ktR]=WDKV+KRht |
[512+64] |
| 6 |
对潜向量做 RMSNorm |
[512] |
| 7 |
对位置段做 RoPE |
[64] |
| 8 |
写入缓存:追加 (ctKV, ktR) |
每 token 共 576 个数 |
第 1、5、6 步里的 RMSNorm,以及第 5 步把两个投影合并成一次矩阵乘,是开源实现里的细节,不影响原理。
6.2 训练与 prefill:展开形式
prefill 一次处理很多 token,计算量大,瓶颈在算力,所以直接把 K、V 还原出来,走普通的多头注意力:
kjC=WUKcjKV∈R[128,128],vj=WUVcjKV∈R[128,128]
每个头做因果注意力,q⋅k 的维度是 192,v 的维度是 128:
ot,i=j≤t∑softmaxj(192qt,i⊤kj,i)vj,i
最后拼接所有头并做输出投影:
ut=WO[ot,1;…;ot,128],128×128=16384 → 7168
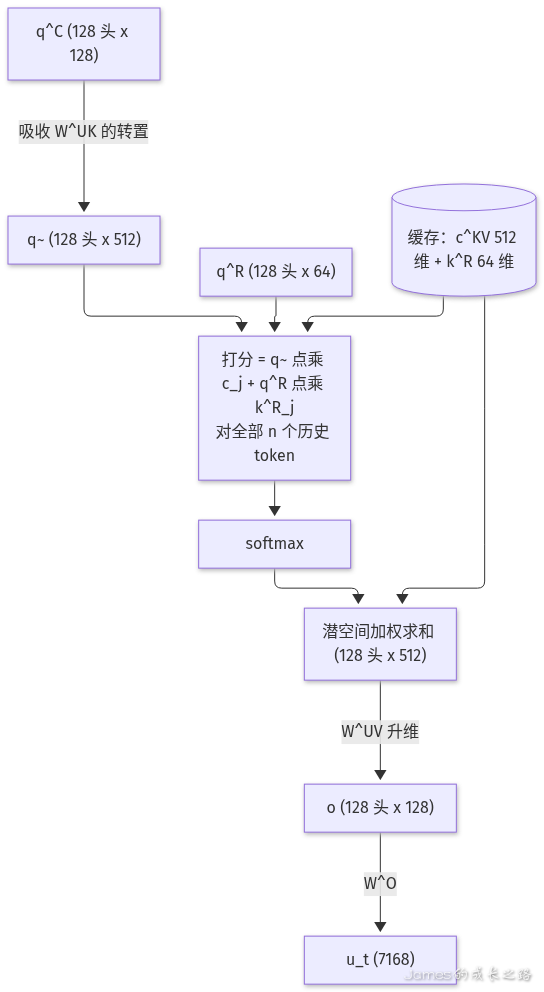
6.3 decode:吸收形式
decode 每步只算一个新 token,但要读很长的缓存,瓶颈在读缓存的带宽。这时用吸收技巧,不还原历史 K、V,直接在 512 维潜空间里算:
| 步骤 |
运算 |
形状 |
| a |
吸收到 query:q~t,i=(WiUK)⊤qt,iC |
[128,512] |
| b |
拼接成每头的有效 query:[q~t,i; qt,iR] |
[128,576] |
| c |
取出缓存的键 [cjKV;kjR],所有头共用 |
[n,576] |
| d |
打分,并除以 192 |
[128,n] |
| e |
softmax,得到注意力权重 at,j(i) |
[128,n] |
| f |
在潜空间加权:oˉt,i=∑jat,j(i)cjKV |
[128,512] |
| g |
升维:ot,i=WiUVoˉt,i |
[128,128] |
| h |
拼接并输出投影:ut=WO[ot,1;…;ot,128] |
[7168] |
对应的数据流如下:
6.4 为什么 prefill 和 decode 用不同形式
这是工程实践里的做法,不是 MLA 论文里的公式。
|
展开形式(prefill) |
吸收形式(decode) |
| 每个 token 的 q⋅k 点积维度 |
192 |
576 |
| 是否要还原历史 K、V |
要,但一次批量算完 |
不要 |
| 主要瓶颈 |
算力(token 多) |
访存(缓存大) |
| 取舍 |
点积维度小,FLOPs 低 |
点积维度大,但省去反复上投影、读缓存少 |
吸收后点积维度从 192 涨到 576,算得更多,所以算力吃紧的 prefill 不用它。decode 受带宽限制,多算一点没关系,缓存读得少才重要,所以用它。
7. MLA 解决了什么,还剩什么
|
MHA |
MLA |
| 每 token 每层缓存 |
32768 |
576 |
| 缓存条数 |
n |
仍是 n |
| 每步注意力的计算 |
对 n 个 token |
仍对 n 个 token |
一个有用的直觉:576=2.25×(2×128),也就是 MLA 的缓存量大约相当于 2.25 组 GQA(推算)。但它保留了完整的多头 query,表达能力比同等缓存的 GQA 更强。
MLA 压缩的是每个 token 存多少,没有减少有多少个 token 要存、要算。代入长上下文:
576×2 B×61≈70 KB / token⇒106 token≈70 GB / 序列
以上为推算,假设 BF16 缓存。实际部署常配合低精度缓存,数字会更小,但量级问题依然存在。
而且每个新 token 都要和这 106 个历史 token 做一遍注意力。
8. 后续:DSA 与 V4 如何接着解决"长度"
下面这一节只给出方向,细节留到后续文章。数字来自论文原文。
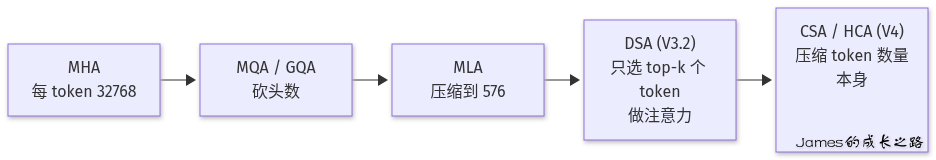
- DeepSeek-V3.2 的 DSA(DeepSeek Sparse Attention):用一个轻量的 Lightning Indexer 给历史 token 打分,每个 query 只对分数最高的 top-k(论文取 2048)个 token 做注意力。它构建在 MLA 的 MQA 形态之上,也就是本文第 5 节的吸收形态。参见 DeepSeek-V3.2-Exp 论文。
- DeepSeek-V4 的 CSA / HCA:先在序列维度把每 m 个 token 的 KV 压成 1 条,再做稀疏选择(CSA),或者压得更狠、直接稠密注意力(HCA)。论文报告在 1M 上下文下,V4-Pro 只需要 V3.2 约 27% 的单 token 推理 FLOPs 和约 10% 的 KV Cache。参见 DeepSeek-V4 论文。
可以看到:
- MLA 压缩的是 每个 token 的宽度;
- DSA 减少的是 每步参与计算的 token 数;
- V4 进一步压缩的是 要存的 token 条数。
9. 自测问题
学完上面的内容,可以试着不看文章回答:
- 为什么 MLA 不能直接对缓存里的 cKV 做 RoPE,而必须多存一个 64 维的 kR?"直接做"破坏了什么?
- 吸收之后,每个 query 头面对的键和值分别是几维?为什么说它等价于一个单头 MQA?
- 为什么 prefill 用展开形式、decode 用吸收形式?从瓶颈的角度解释。
- MLA 把每 token 的缓存压到了 576,为什么上下文拉到 1M 时问题依然严重?
参考资料